Retrieval-grounded translation
Studying how retrieved examples affect terminology-sensitive English-to-Thai product and service translation.
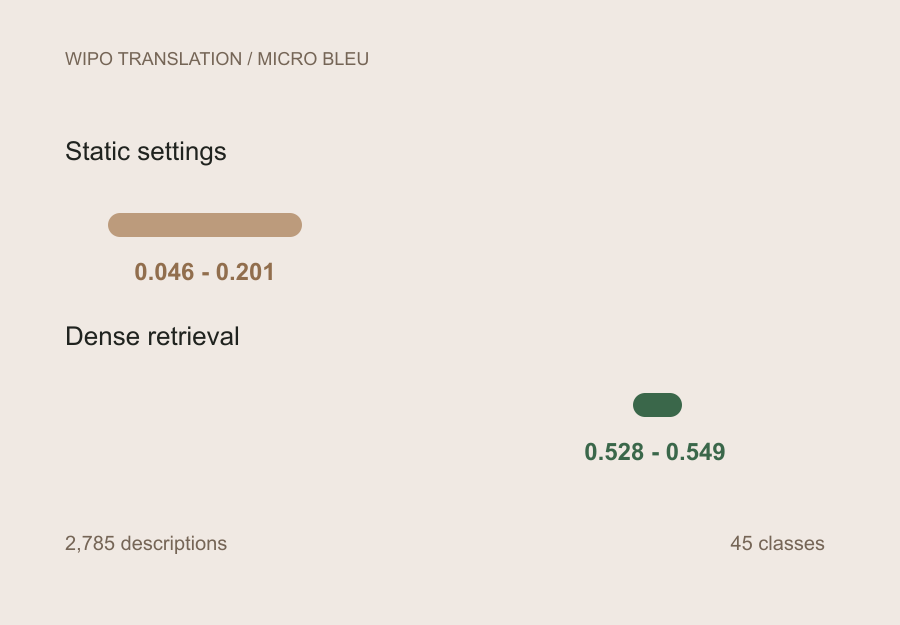
Reported micro BLEU ranges across static settings and dense-retrieval settings; values are scores on a 0–1 scale.
The research question
Product and service descriptions require consistent terminology across specialized classification classes. This work examines how context and example retrieval change translation quality under a reproducible evaluation protocol.
Experimental design
The evaluation covers 2,785 English descriptions across 45 WIPO Nice Classification classes, each with an institutionally accepted Thai reference. Six settings compare direct prompting, class context, fixed class-conditioned examples, lexical retrieval with FTS5/BM25, MiniLM/FAISS retrieval, and BGE-M3/FAISS retrieval.
Gemma-3-1B-IT, Qwen3-1.7B, and Mistral-7B-Instruct were evaluated using vLLM on one NVIDIA A100 GPU.
Results and interpretation
Dense retrieval reached 0.528–0.549 micro BLEU, versus 0.046–0.201 for static settings, with mean CER of 0.265–0.301 under failure-aware scoring. Generation failures remained in the evaluation rather than being removed.
These ranges describe the reported settings, not a universal improvement guarantee for other translation domains.
Related NLP work
I also built a Thai–Chinese lexical-constraint pipeline using Thai segmentation, Jieba, BPE/subword-nmt, fast_align, and grow-diag-final-and, selecting low-frequency, POS-filtered terminology. Offline Qwen-14B/72B GGUF inference through llama.cpp supported experiments in restricted HPC environments.
Manuscript status
Constraint-Based Neural Machine Translation for WIPO Product and Service Descriptions. Manuscript under review, iSAI-NLP 2026. Status shown reflects the current CV; no acceptance or publication is claimed.